はてなブログの記事を全部消そうと思うと、ブログごと削除(URLは再利用不可)か20記事位ずつポチポチ消すしかない。
以前Pythonで作ったプログラムはこちら
【取り扱い注意】はてなブログクリーナー – 脳髄直焼経過記録
Seleniumとかめんどいなぁと思っていたので、今回はGeminiに作ってもらった。カンタン。
import requests
import xml.etree.ElementTree as ET
import time

# --- 実行前に以下の3つの変数を設定 ---
HATENA_ID = 'your_hatena_id'
BLOG_ID = 'your_blog_id.hatenablog.com' # 例: example.hatenablog.com
API_KEY = 'your_api_key' # ダッシュボード > 詳細設定 > AtomPub API キー

BASE_URL = f"https://blog.hatena.ne.jp/{HATENA_ID}/{BLOG_ID}/atom/entry"

def delete_all_entries():
    next_url = BASE_URL

    while next_url:
        response = requests.get(next_url, auth=(HATENA_ID, API_KEY))
        if response.status_code != 200:
            print(f"エラー: エントリ一覧の取得に失敗 (ステータスコード: {response.status_code})")
            print(response.text)
            break

        root = ET.fromstring(response.text)
        ns = {'ns': 'http://www.w3.org/2005/Atom'}

        entries = root.findall('ns:entry', ns)
        if not entries:
            break

        for entry in entries:
            edit_url = None
            for link in entry.findall('ns:link', ns):
                if link.get('rel') == 'edit':
                    edit_url = link.get('href')
                    break

            if edit_url:
                del_resp = requests.delete(edit_url, auth=(HATENA_ID, API_KEY))
                if del_resp.status_code == 200:
                    print(f"削除完了: {edit_url}")
                else:
                    print(f"削除失敗: {edit_url} (ステータスコード: {del_resp.status_code})")

                # サーバ負荷軽減およびAPIリミット回避のための待機
                time.sleep(1)

        next_url = None
        for link in root.findall('ns:link', ns):
            if link.get('rel') == 'next':
                next_url = link.get('href')
                break

if __name__ == "__main__":
    # pip install requests
    delete_all_entries()
スクリプト実行の前提条件
- 外部ライブラリの導入 コマンドラインにて
pip install requestsを実行済であること。 - 認証情報(AtomPub)の取得 はてなブログダッシュボードの「設定」>「詳細設定」>「AtomPub」の項目に記載されている「ルートエンドポイント」から
BLOG_IDを、「APIキー」からAPI_KEYを取得し、コード内に転記する。 - 不可逆性の担保 当APIによるDELETEリクエストはごみ箱を経由せず即時完全削除される。実行後の復元手段は存在しない。
以下個人的なアレコレ
まず、バックアップを取ること。https://blog.hatena.ne.jp/my/export/movable_type
インポートはワンクリックで取り消しできるので、削除前にインポート記事がないかを確認し、母数を減らすと作業時間を短縮できそう。https://blog.hatena.ne.jp/my/import
過去記事のリンクの修正
バックアップしたテキストを編集するとよい。
これもAIにあれこれ言うといい感じのプログラムを吐いてくれる。いい時代だ。
複数の構成
私は
- はてなダイアリ時代(d.hatena.ne.jp%2Felve%2F、d.hatena.ne.jp/elve/)
- 無課金時代(elve.hatenadiary.jp)
- サブドメイン時代(snack.elve.club)
があり、それぞれURLの構成が違って死にかけたw
例えば下のヘッダーを持つ記事をそのまま読み込むとURLのドメインの後に付くのは /entry/archives/2898 となる
/entry/2017/04/25/214317 になって欲しい。これはもう正規表現使った一括置換ではどうにもできん、と(できるかもだけどワイの能力では無理)。
--------
AUTHOR: elated
TITLE: No.1216 ブクマのブクマ。PCだとこうだよね。スマホがわからないorz
BASENAME: archives/2898
STATUS: Publish
ALLOW COMMENTS: 1
CONVERT BREAKS: 0
DATE: 04/25/2017 21:43:17
CATEGORY: はてなブログhttp時代
-----
No.1216 ブクマのブクマ。PCだとこうだよね。スマホがわからないorz – 脳髄直焼経過記録
ブクマページは例外
あと、旧ブクマと称してブックマークのURLを引っ張っているページもある
No.1495 本能的な何かなのかなぁ 痴漢と魔女と育成と排除 – 脳髄直焼経過記録

こういうところは置換しないで欲しいぞ、と。
なんやかんやで置換したもの再度インポートしました。
失敗
Power Automateで1画面(20記事位?)ずつ消すのも作ったけど遅くてお話にならんかった
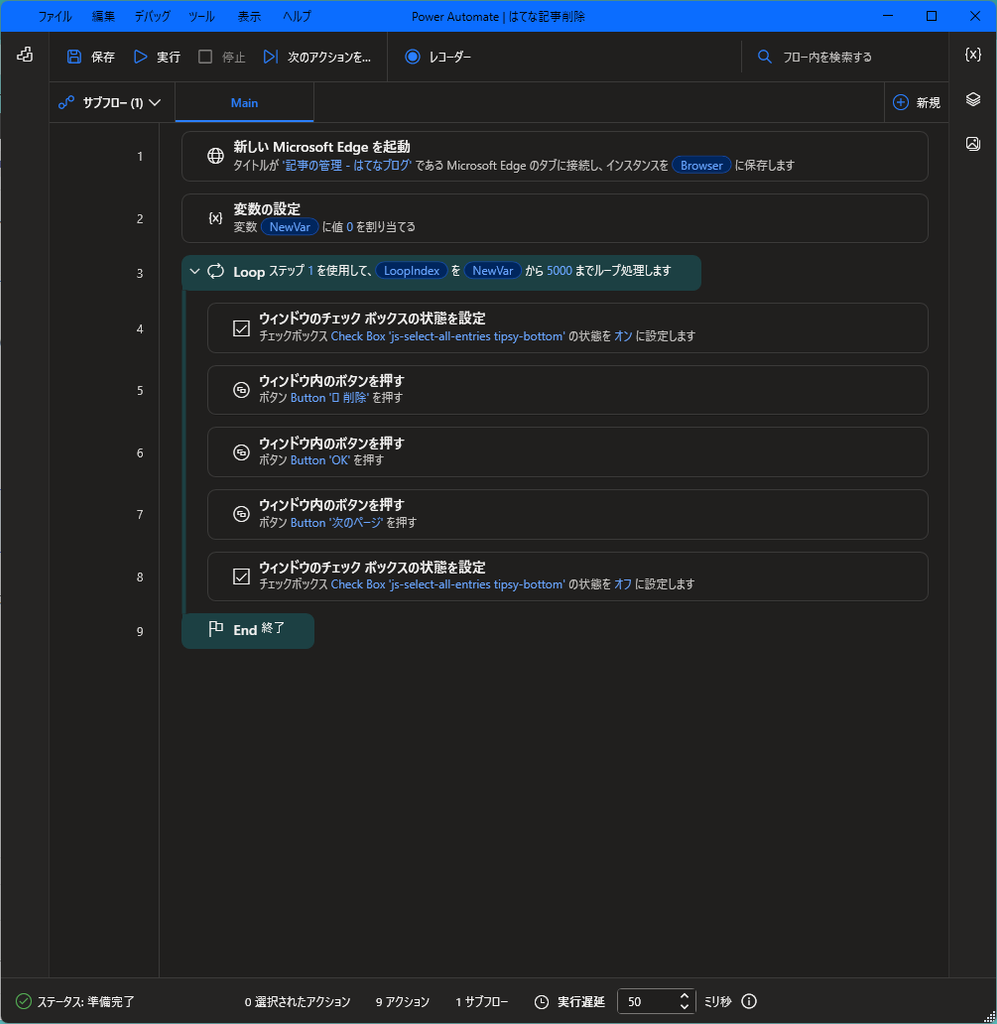
あと、新しいフロー作ろうとしたらエラーが出て使えなくなっちゃう。
多分画面を外付けディスプレイにしてるせいっぽいけど直せなかったので、既存のフローをコピーして中身全削除して作った
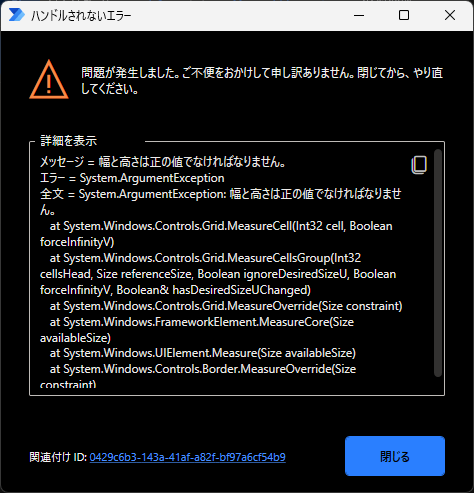
Power Automate Desktop 2.73 – System.ArgumentException when creating a new flow
チュートリアル開始してスキップでいけるっぽいけどダメだった(´・ω・`)